Artist Recommender

Επιλέξτε 1 έως 5 καλλιτέχνες ή ένα έτοιμο σενάριο και συγκρίνετε τα 3 στάδια του αλγορίθμου.

Σύνδεση με backend...
Αυτόματες Μουσικές Συστάδες
—
AgglomerativeClustering
Μέση Ακουστική Ομοιότητα
—
Cosine Similarity στις 123 διαστάσεις
Αποφυγή Σφάλματος Μέσου
—
Averaging Trap Loss Prevention

Οι 5 Προτεινόμενοι Καλλιτέχνες

Ενεργός: Hybrid (Collaborative - Content Based)
⚙️ Πώς προέκυψε αυτό το αποτέλεσμα;

Πώς δουλεύει

Μέρος Α: Content-Based Filtering (Χαρακτηριστικά Ήχου & Δυναμικές Συστάδες) ΣΥΜΠΤΥΞΗ −

1. Προεπεξεργασία Δεδομένων & Προφίλ Καλλιτεχνών (spotify.csv)

Ξεκινάμε από $114.000$ εγγραφές τραγουδιών του Spotify. Αφαιρούμε κενές τιμές και διπλότυπα τραγούδια ανά καλλιτέχνη (drop_duplicates(subset=['artists', 'track_name'])) ώστε επανεκδόσεις του ίδιου κομματιού να μην αλλοιώνουν τον μέσο όρο, φτάνοντας στα $81.343$ μοναδικά τραγούδια και $31.437$ καλλιτέχνες.

Για κάθε καλλιτέχνη (groupby('artists')) υπολογίζουμε τη μέση τιμή των $9$ ακουστικών χαρακτηριστικών (danceability, energy, loudness, speechiness, acousticness, instrumentalness, liveness, valence, tempo) και κρατάμε το κυρίαρχο μουσικό είδος (track_genre μέσω mode). Κρατάμε $11.402$ φιλτραρισμένα προφίλ ($\ge 2$ τραγούδια ή παρουσία στο Last.fm) για στατιστικά αξιόπιστους μέσους όρους.

2. Κανονικοποίηση Κλίμακας (MinMaxScaler)

Τα $9$ χαρακτηριστικά του Spotify βρίσκονται σε τελείως διαφορετικές κλίμακες (danceability $\in [0, 1]$, loudness $\in [-60, 0]\text{ dB}$, tempo $\in [50, 220]\text{ BPM}$). Μεταφέρουμε όλες τις στήλες στο $[0, 1]$ με τον MinMaxScaler:

$$x'_i = \frac{x_i - x_{\min}}{x_{\max} - x_{\min}} \in [0, 1]$$

Αριθμητική Απόδειξη Σφάλματος χωρίς Scaling

Έστω Καλλιτέχνης $X = [0.80, 120]$ και Καλλιτέχνης $Y = [0.20, 128]$ (τιμές [danceability, tempo]):

$$\cos(\theta_{\text{raw}}) = \frac{(0.80 \times 0.20) + (120 \times 128)}{\sqrt{0.80^2 + 120^2}\cdot\sqrt{0.20^2 + 128^2}} = \frac{15360.16}{120.0027 \times 128.0002} = \mathbf{0.999989}$$

Λόγω του tempo ($120 \times 128$), δύο εντελώς διαφορετικοί καλλιτέχνες φαίνονται $99.999\%$ όμοιοι. Η κανονικοποίηση δίνει σε όλα τα χαρακτηριστικά ίσο βάρος.

3. Κωδικοποίηση Είδους (One-Hot Encoding, $w_{\text{genre}} = 0.5$) → 123 Διαστάσεις

Δύο καλλιτέχνες από διαφορετικά είδη μπορεί να έχουν παρόμοιο μέσο energy και tempo. Γι' αυτό μετατρέπουμε τα $114$ μουσικά είδη (track_genre) σε δυαδικές στήλες $\{0, 1\}$ πολλαπλασιασμένες με συντελεστή βαρύτητας $w_{\text{genre}} = 0.5$:

  • Κάθε καλλιτέχνης περιγράφεται από ένα διάνυσμα $9 + 114 = 123$ διαστάσεων.
  • Αν δύο καλλιτέχνες ανήκουν στο ίδιο είδος, προστίθεται $0.5 \times 0.5 = \mathbf{+0.25}$ στο εσωτερικό τους γινόμενο — αρκετό για να ξεχωρίζει τα είδη, χωρίς να καλύπτει τις λεπτομέρειες των $9$ ακουστικών χαρακτηριστικών.

4. Δυναμικές Συστάδες (AgglomerativeClustering) & «Η Παγίδα του Μέσου Όρου»

Ένας ακροατής σπάνια ακούει μόνο ένα είδος. Αν βάλει ετερόκλητους καλλιτέχνες (π.χ. System Of A Down metal + The Prodigy breakbeat, ή Queen rock + Eminem hip-hop + Miles Davis jazz), ένας απλός ενιαίος μέσος όρος (Averaging Trap) πέφτει στη «νεκρή ζώνη» ανάμεσα στα είδη, προτείνοντας καλλιτέχνες που δεν εκφράζουν κανένα από τα γούστα του.

Η συνάρτηση cluster_user_artists_content υπολογίζει τη μήτρα αποστάσεων $d = 1 - \cos(\theta)$ στις $123$ διαστάσεις (προσθέτοντας ποινή $+0.15$ όταν δύο καλλιτέχνες έχουν διαφορετικό μουσικό είδος) και χωρίζει αυτόματα τους καλλιτέχνες εισόδου σε $N$ ομοιογενείς συστάδες με AgglomerativeClustering (distance_threshold = 0.08). Οι $5$ προτάσεις κατανέμονται έπειτα δίκαια στις $N$ συστάδες.

5. Υπο-Κεντροειδές ($\vec{u}_{\text{cluster}}$) & Cosine Similarity με Αριθμούς

Μέσα σε κάθε συστάδα ξεχωριστά, υπολογίζεται πρώτα το Sub-Centroid ($\vec{u}_{\text{cluster}}$, ο μέσος όρος των διανυσμάτων της συστάδας) και έπειτα η ομοιότητα κάθε υποψηφίου με Cosine Similarity. Παράδειγμα στον 2D χώρο $[\text{Energy}, \text{Valence}]$:

Έστω μια συστάδα 3 Rock καλλιτεχνών: $A_1 = [0.80, 0.70]$ (Queen), $A_2 = [0.60, 0.90]$ (The Beatles) και $A_3 = [0.70, 0.50]$ (Led Zeppelin). Το Sub-Centroid είναι:

$$u_{\text{cluster, Energy}} = \frac{0.80 + 0.60 + 0.70}{3} = 0.70, \quad u_{\text{cluster, Valence}} = \frac{0.70 + 0.90 + 0.50}{3} = 0.70 \implies \vec{u}_{\text{cluster}} = [0.70, 0.70]$$

Συγκρίνουμε δύο υποψηφίους ($C_1 = [0.65, 0.75]$ παρόμοιος, $C_2 = [0.20, 0.90]$ πολύ χαμηλότερο energy) με τον τύπο $\cos(\theta) = \frac{\vec{u}_{\text{cluster}} \cdot \vec{C}}{\|\vec{u}_{\text{cluster}}\| \|\vec{C}\|}$:

  • Υποψήφιος $C_1 = [0.65, 0.75]$: Εσωτερικό γινόμενο $(0.70 \times 0.65) + (0.70 \times 0.75) = 0.980$, μέτρα $0.9899 \times 0.9925 = 0.9825 \implies \cos(\theta_1) = \mathbf{0.9975}$ ($99.75\%$ ομοιότητα).
  • Υποψήφιος $C_2 = [0.20, 0.90]$: Εσωτερικό γινόμενο $(0.70 \times 0.20) + (0.70 \times 0.90) = 0.770$, μέτρα $0.9899 \times 0.9220 = 0.9127 \implies \cos(\theta_2) = \mathbf{0.8436}$ ($84.36\%$ ομοιότητα).

Στον κώδικα, ακριβώς αυτή η πράξη τρέχει στις $123$ διαστάσεις με np.mean και cosine_similarity.

6. Πρακτικά Αποτελέσματα & Πολιτισμική Τυφλότητα

Οι δοκιμές στο live backend δείχνουν καθαρά τι πετυχαίνει και πού κολλάει το σκέτο Μέρος Α:

Είσοδος (Seed) Συστάδα & Προτάσεις Μέρους Α Είδος Content Sim (123-D) Τι παρατηρούμε
Queen Imagine Dragons / Twenty One Pilots / Bastille rock 0.9917
0.9894
Ίδιος ήχος, αλλά $40$ χρόνια νεότερη pop-rock σκηνή
Eminem Karan Aujla / Sidhu Moose Wala hip-hop 0.9953
0.9950
Μοντέρνο Punjabi hip-hop με παρόμοιο BPM (άλλη κουλτούρα)
Miles Davis BLOSSOM DEARIE / Chet Baker jazz 0.9951
0.9945
Πολύ υψηλή ακουστική & ειδική ταύτιση
System Of A Down + The Prodigy Cluster 1: Disturbed
Cluster 2: Aphrodite
metal
breakbeat
0.9971
0.9979
Χωρίζει σωστά τα 2 είδη αποφεύγοντας το Averaging Trap

Συμπέρασμα Μέρους Α (Γιατί χρειαζόμαστε το Μέρος Β;)

Το Content-Based Filtering με Sub-Centroids λύνει το πρόβλημα της μίξης ειδών, αλλά πάσχει από «Πολιτισμική Τυφλότητα»: βλέπει μόνο ακουστικούς αριθμούς και αγνοεί την εποχή, τη γλώσσα και το κοινό. Για να μάθει το σύστημα ποιοι καλλιτέχνες ακούγονται μαζί στην πράξη, περνάμε στο Μέρος Β.

Μέρος Β: Collaborative Filtering (Συνήθειες Ακροατών Last.fm) ΣΥΜΠΤΥΞΗ −

1. Τι κάνει το Collaborative Filtering & Πίνακας Ακροάσεων

Εδώ το σύστημα δεν «ακούει» καθόλου τον ήχο (BPM, energy ή είδος). Βασίζεται αποκλειστικά στη συλλογική συμπεριφορά: «αν πολλοί χρήστες ακούνε ταυτόχρονα τον Καλλιτέχνη Α και τον Καλλιτέχνη Β, τότε οι δύο καλλιτέχνες συνδέονται».

Χρησιμοποιούμε $92.834$ εγγραφές ακροάσεων από $1.892$ χρήστες του Last.fm ($3.374$ κοινοί καλλιτέχνες με το Spotify) για να κατασκευάσουμε τον αραιό πίνακα Χρήστης $\times$ Καλλιτέχνης ($R$), όπου $R_{u,i}$ είναι το πλήθος ακροάσεων (play count) του χρήστη $u$ για τον καλλιτέχνη $i$.

2. Γιατί εφαρμόζουμε Λογαριθμική Συμπίεση (np.log1p)

Στα πραγματικά δεδομένα ακροάσεων, ένας φανατικός ακροατής μπορεί να έχει $10.000$ plays για ένα συγκρότημα, ενώ ένας μέσος ακροατής έχει $20$. Χωρίς συμπίεση, ένας μόνος «φανατικός» χρήστης θα είχε $500\times$ μεγαλύτερο βάρος από έναν κανονικό ακροατή. Εφαρμόζουμε:

$$R'_{u,i} = \ln(1 + R_{u,i})$$
  • $1$ ακρόαση $\rightarrow \ln(2) \approx \mathbf{0.69}$
  • $20$ ακροάσεις $\rightarrow \ln(21) \approx \mathbf{3.04}$
  • $10.000$ ακροάσεις $\rightarrow \ln(10001) \approx \mathbf{9.21}$ (η διαφορά $500\times$ μειώνεται σε μόλις $\sim 3\times$)

3. Item-Item Cosine Similarity (Επικάλυψη Κοινού)

Στη συνέχεια παίρνουμε τον ανάστροφο πίνακα και υπολογίζουμε το cosine_similarity ανάμεσα σε κάθε ζεύγος καλλιτεχνών με βάση το ποιους κοινούς ακροατές μοιράζονται. Παραδείγματα από τον πραγματικό πίνακα Last.fm:

  • Queen $\leftrightarrow$ The Beatles: 0.358 (πολλοί κοινοί ακροατές κλασικού ροκ)
  • Eminem $\leftrightarrow$ 2Pac: 0.304 (ισχυρό κοινό κοινό hip-hop)
  • Queen $\leftrightarrow$ 2Pac: 0.000 (ελάχιστη έως μηδενική επικάλυψη)

4. Πού πετυχαίνει & Πού αποτυγχάνει (Popularity Bias)

Όταν δοκιμάζουμε σκέτο Collaborative Filtering, φαίνεται καθαρά τόσο η δύναμη όσο και η παγίδα του:

Seed Καλλιτέχνης Top Προτάσεις Μέρους Β (Last.fm Users) Είδος Spotify Collab Sim Αξιολόγηση Αποτελέσματος
Queen Pink Floyd psych-rock 0.385 Σωστό 70s Classic Rock
Led Zeppelin hard-rock 0.371 Ίδια εποχή & σκηνή
The Beatles / AC/DC psych-rock / hard-rock 0.358 / 0.342 Απολύτως συναφές κοινό
Eminem Katy Perry dance 0.335 Παγίδα Δημοτικότητας (Pop Bias)
Black Eyed Peas dance 0.317 Κοινό ραδιοφωνικό κοινό
Britney Spears dance 0.305 Αγνοεί εντελώς τον ήχο hip-hop

Συμπέρασμα Μέρους Β

Το Collaborative Filtering εντοπίζει άριστα την εποχή και τη μουσική σκηνή, αλλά για mainstream καλλιτέχνες (όπως ο Eminem) μπερδεύεται από ακροατές που ακούν γενικά top-40 ραδιόφωνο, προτείνοντας pop/dance ονόματα (Mainstream / Popularity Bias).

Μέρος Γ: Υβριδικό Σύστημα Δύο Σταδίων (Collaborative → Content-Based) ΣΥΜΠΤΥΞΗ −

1. Σύγκριση των 3 Προσεγγίσεων

Μέρος Αλγορίθμου Τι κάνει Πού αποτυγχάνει Παράδειγμα
Μέρος Α: Μόνο Content Ψάχνει σε όλο το Spotify ($11.402$ καλλιτέχνες) με βάση μόνο τα 123-D ηχητικά χαρακτηριστικά. Αγνοεί εποχή και κοινό (Πολιτισμική Τυφλότητα). Για Queen προτείνει Imagine Dragons.
Μέρος Β: Μόνο Collaborative Ψάχνει ποιους καλλιτέχνες ακούνε μαζί οι χρήστες στο Last.fm ($3.374$ προφίλ). Παρασύρεται από εμπορικές mainstream επιτυχίες (Popularity Bias). Για Eminem βάζει #1 την Katy Perry.
Μέρος Γ: Cascade (Collab $\rightarrow$ Content) Στάδιο 1: Κρατάει τους Top-35 του Last.fm.
Στάδιο 2: Τους κατατάσσει στον ήχο 123-D με το Sub-Centroid.
Μηδενίζει ταυτόχρονα και τα δύο σφάλματα. Για Eminem βγάζει Nicki Minaj, Kid Cudi, 50 Cent. Για Queen βγάζει Rolling Stones, AC/DC.

2. Αναλυτική Λειτουργία της Αρχιτεκτονικής Cascade

  1. Βήμα 0 — Υβριδική Ομαδοποίηση (cluster_user_artists_hybrid) & Κατανομή: Υπολογίζει μια μεικτή απόσταση ($50\%$ Content 123-D + $50\%$ Last.fm Collaborative) ανάμεσα στους καλλιτέχνες που έδωσε ο χρήστης και τους χωρίζει με AgglomerativeClustering σε $N$ συστάδες (π.χ. Rock, Rap, Jazz). Έπειτα μοιράζει δίκαια τις $5$ προτάσεις ανάλογα με το μέγεθος κάθε συστάδας.
  2. Στάδιο 1 — Κοινωνικό Φίλτρο (Collaborative Candidate Generation): Για κάθε συστάδα ξεχωριστά, επιλέγει μόνο τους Top-35 καλλιτέχνες από τον πίνακα Last.fm (`collab_sim > 0.08`). Έτσι, μέσα στη λίστα μπαίνουν μόνο καλλιτέχνες που είναι αποδεδειγμένα συναφείς στη συνείδηση των ακροατών. (Αν ένας καλλιτέχνης δεν έχει αρκετά στοιχεία στο Last.fm, ενεργοποιείται αυτόματα fallback από το 123-D pool του Spotify).
  3. Στάδιο 2 — Ακουστικός Κριτής (Content-Based Re-Ranking): Υπολογίζει το Sub-Centroid ($\vec{u}_{\text{cluster}}$) της συστάδας και κατατάσσει μόνο αυτούς τους 35 υποψηφίους με βάση το 123-D Cosine Similarity. Οι καλλιτέχνες της ίδιας κουλτούρας που έχουν και το σωστό ηχητικό προφίλ ανεβαίνουν στην κορυφή.

3. Γιατί ΠΡΩΤΑ Collaborative και ΜΕΤΑ Content-Based (και όχι ανάποδα);

Αν κάναμε πρώτα Content-Based και μετά Collaborative, το πρώτο στάδιο θα έβρισκε από όλο το Spotify ($11.402$ καλλιτέχνες) αγνώστους ή σύγχρονους καλλιτέχνες που απλώς έτυχε να έχουν ίδιο energy και tempo — πολλοί από τους οποίους δεν υπάρχουν καν στο Last.fm — αφήνοντας απ' έξω θρυλικά συγκροτήματα της ίδιας εποχής. Κάνοντας πρώτα το κοινωνικό φιλτράρισμα και έπειτα τον ηχητικό έλεγχο, κρατάμε τη σωστή εποχή και «καθαρίζουμε» το mainstream/pop θόρυβο.

4. Πρακτική Απόδειξη (Πίνακες Επίδρασης)

Α. Εξάλειψη του Popularity Bias στον Eminem: Το Στάδιο 2 απορρίπτει τις pop προτάσεις του Μέρους Β (Katy Perry, Black Eyed Peas, Britney Spears) και ανεβάζει αμιγώς hip-hop καλλιτέχνες:

Υποψήφιος (Top-35 Last.fm) Είδος Spotify 1. Collab Sim (Last.fm) 2. Content Sim (123-D Audio) Κατάταξη Μέρους Γ
Nicki Minaj hip-hop 0.272 0.9835 #1 Επιλογή (Απορρίπτει το pop)
Kid Cudi hip-hop 0.208 0.9791 #2 Επιλογή
50 Cent hip-hop 0.312 0.9639 #3 Επιλογή
Katy Perry / Black Eyed Peas dance 0.335 / 0.317 0.9075 / 0.9148 Εκτός Top-5 (Χαμηλότερο Audio Fit)

Β. Ακουστική Κατάταξη στον Κατάλογο των Queen:

Υποψήφιος (Στάδιο 1 Collab) Είδος Spotify 1. Collab Sim (Last.fm) 2. Content Sim (123-D Audio) Αποτέλεσμα
The Rolling Stones british / rock 0.320 0.8828 #1 Επιλογή
AC/DC hard-rock 0.342 0.8825 #2 Επιλογή
Aerosmith hard-rock 0.297 0.8809 #3 Επιλογή
Pink Floyd psych-rock 0.385 0.8259 Χαμηλότερο Audio Score

5. Σχήματα Ανάλυσης Δεδομένων από το Notebook

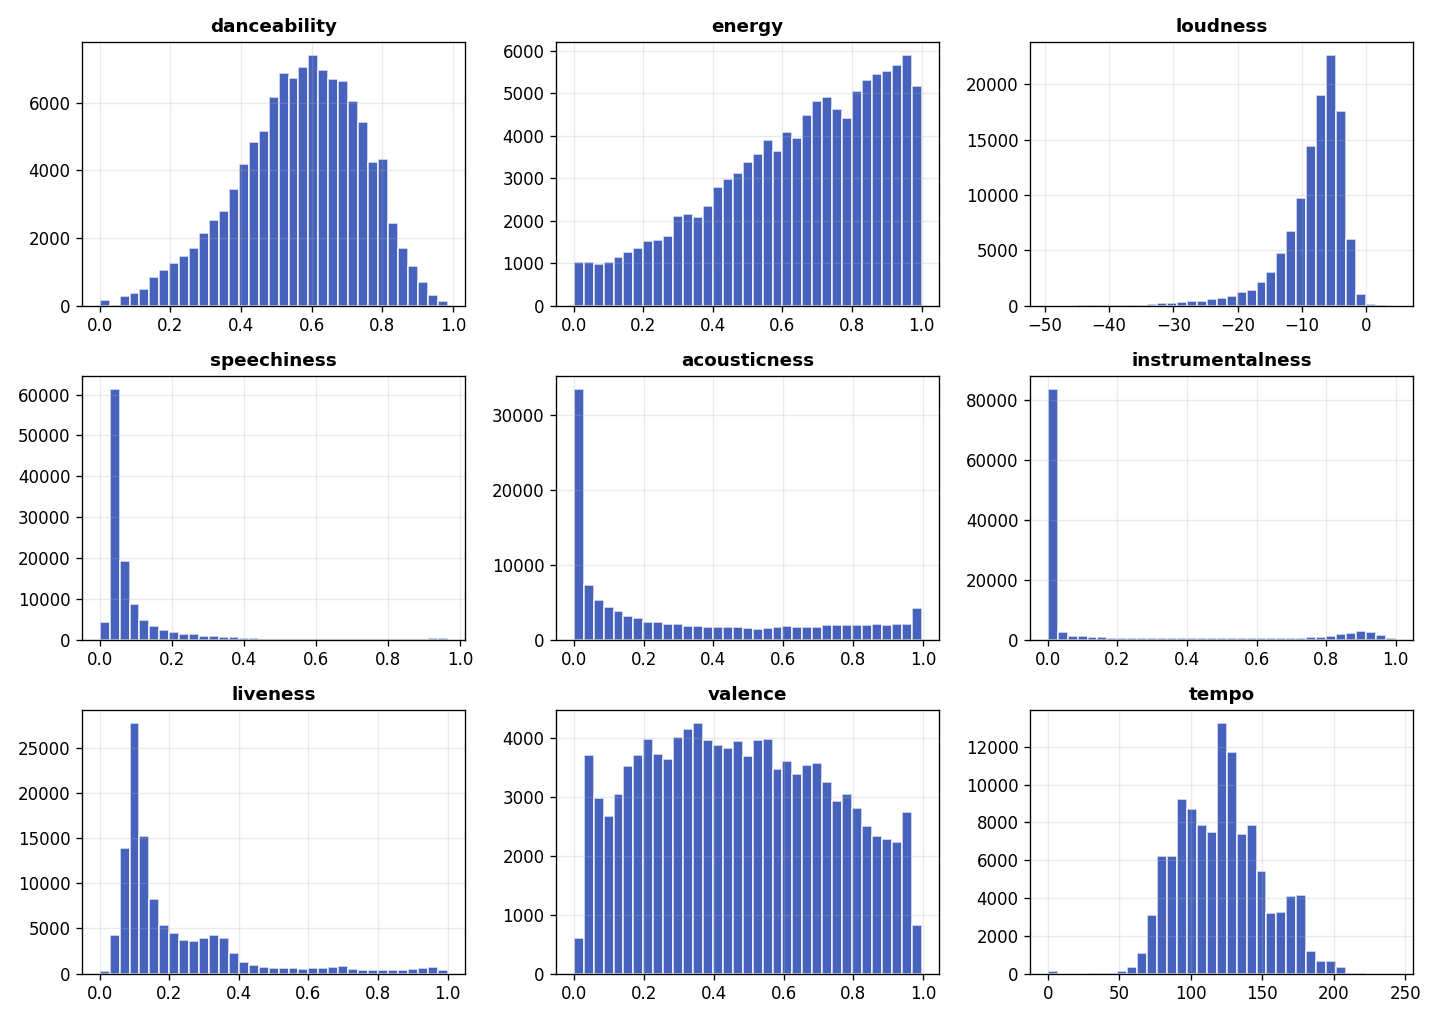
Distribution Plots
Σχήμα 1: Κατανομή δημοτικότητας και τα 15 δημοφιλέστερα είδη στο Spotify.
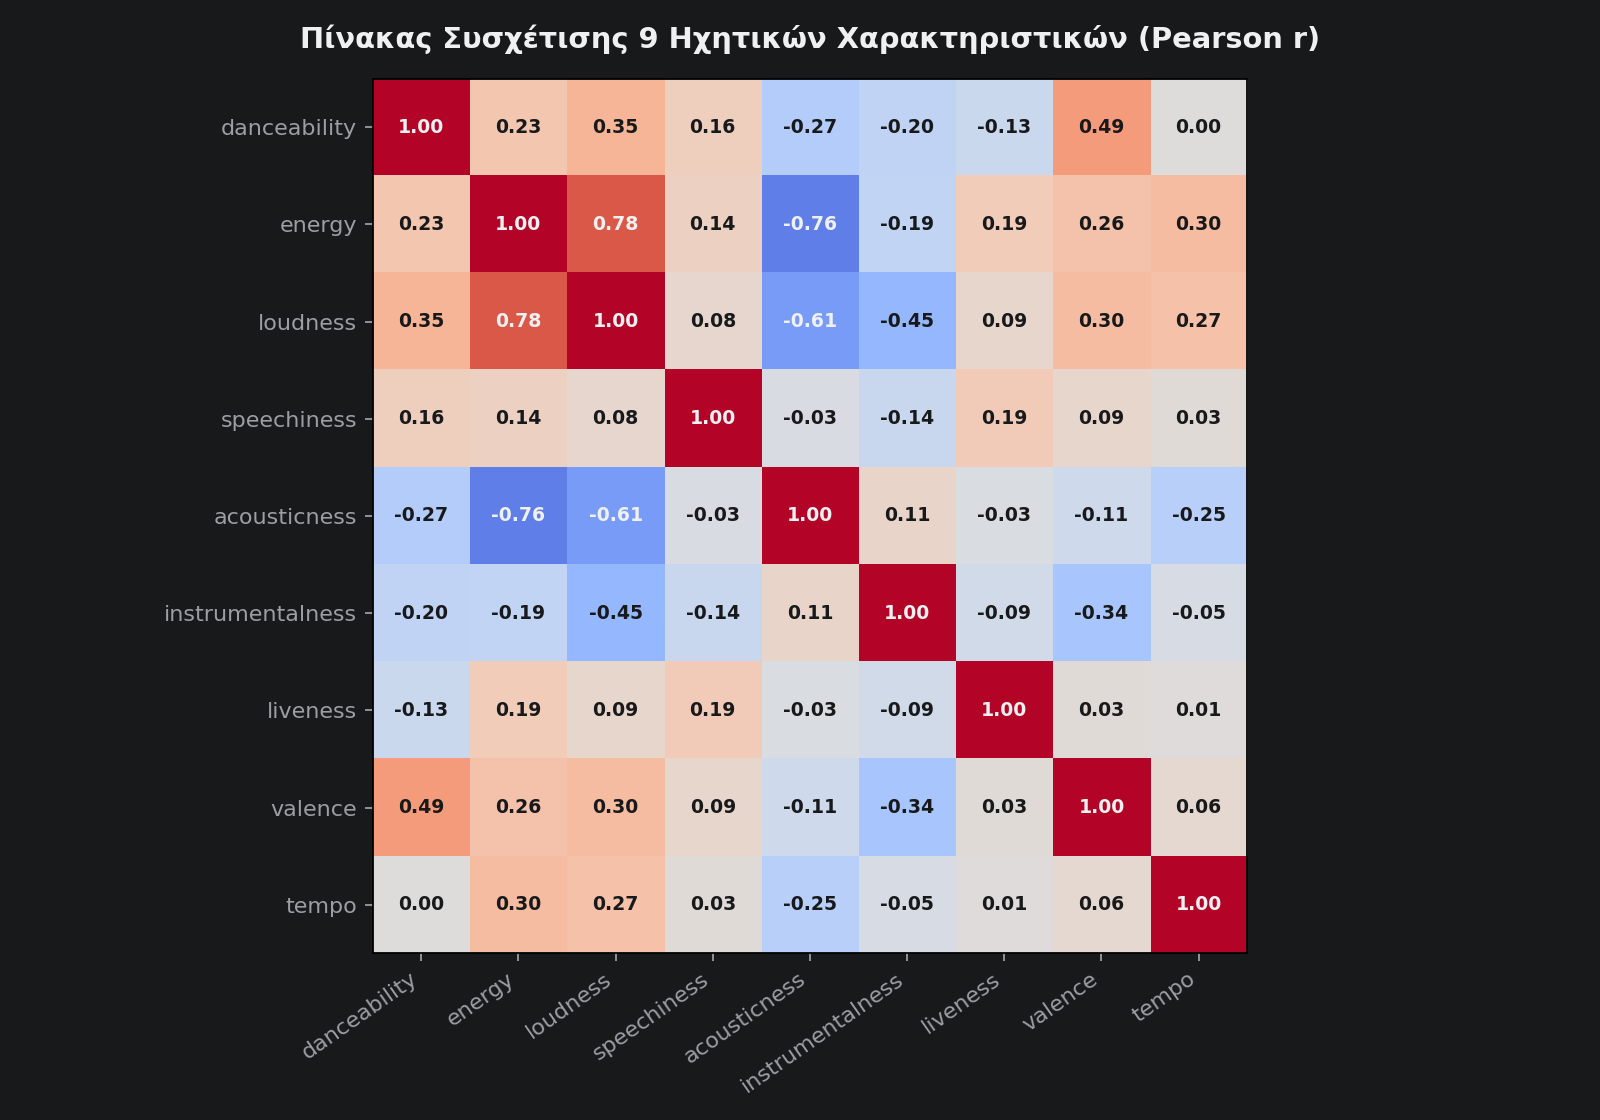
Correlation Heatmap
Σχήμα 2: Πίνακας συσχέτισης των 9 ακουστικών χαρακτηριστικών.
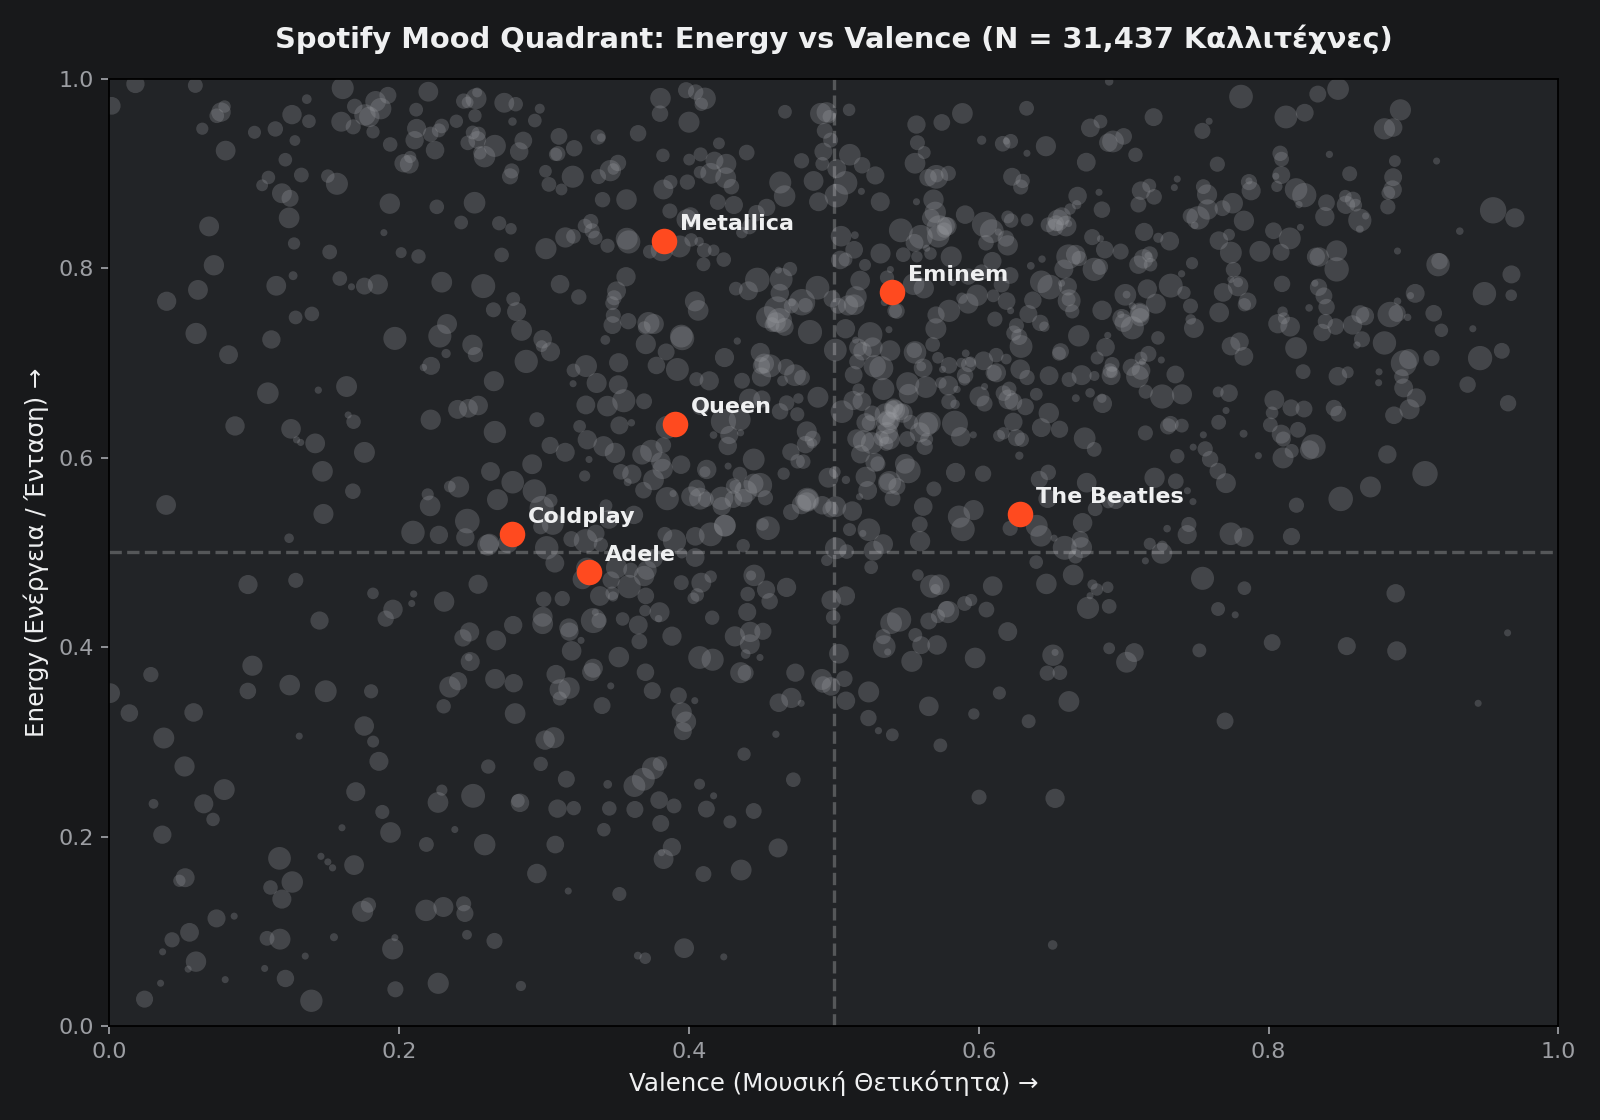
Mood Quadrant
Σχήμα 3: Διάγραμμα διάθεσης (Valence vs Energy) στον χώρο των τραγουδιών.

Ζωντανά Διαγράμματα Διανυσματικού Χώρου

Οπτικοποίηση των συστάδων και των προτάσεων που υπολογίζονται σε πραγματικό χρόνο για τους επιλεγμένους καλλιτέχνες.

1. Χώρος Ηχητικών Χαρακτηριστικών (Energy vs Acousticness)
Τα βέλη δείχνουν τα Sub-Centroids κάθε συστάδας. Το σύμβολο ✕ δείχνει το λάθος του Ενιαίου Μέσου (Averaging Trap).
2. Πολυδιάστατη Προβολή PCA (123 Διαστάσεις → 2D)
Προβολή των 9 ηχητικών χαρακτηριστικών και των 114 One-Hot ειδών στις δύο Κύριες Συνιστώσες (PC1 vs PC2).

Datasets & Πηγές Δεδομένων

Τα δύο δημόσια datasets που συνδυάστηκαν για την κατασκευή του υβριδικού συστήματος.

Spotify Tracks Dataset (spotify.csv)
Content-Based • 123-D

Περιέχει 114.000 κομμάτια (81.343 μοναδικά τραγούδια, 114 μουσικά είδη) με 9 ηχητικά χαρακτηριστικά του Spotify Web API (danceability, energy, loudness, speechiness, acousticness, instrumentalness, liveness, valence, tempo). Στο backend φορτώνονται 11.402 φιλτραρισμένοι καλλιτέχνες.

↗ Προβολή Dataset (Hugging Face / Spotify Tracks)
Last.fm HetRec 2011 (user_artists.dat)
Collaborative • 92.834 Plays

Δημοσιευμένο από το GroupLens Research & Universidad Autónoma de Madrid (HetRec 2011): 1.892 χρήστες, 17.632 καλλιτέχνες και 92.834 εγγραφές ακροάσεων (play counts). Μετά την αντιστοίχιση με το Spotify αξιοποιούνται 3.374 προφίλ Collaborative Filtering.

↗ Προβολή Dataset (GroupLens HetRec 2011)